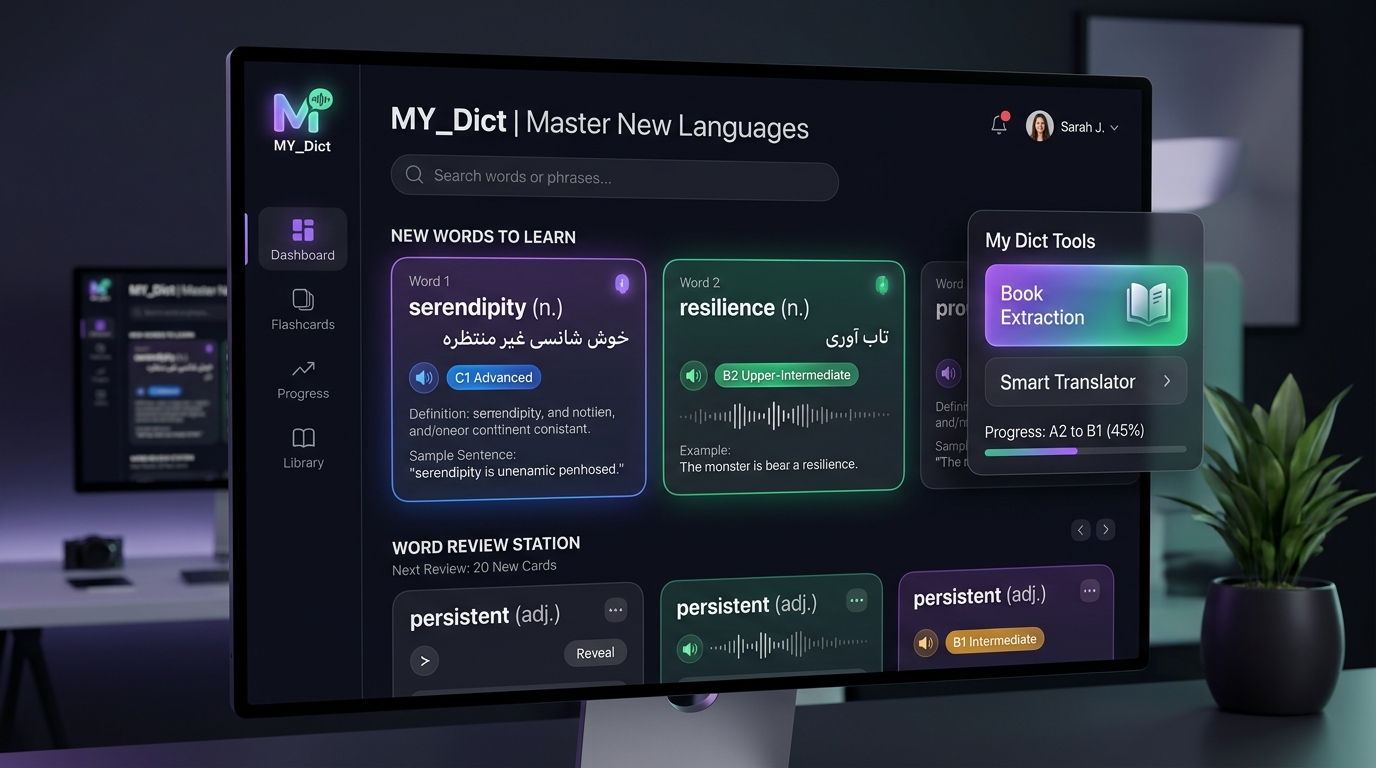
**MY_Dict** یک پلتفرم هوشمند برای یادگیری واژگان انگلیسی از طریق محتوای واقعی مانند کتاب، PDF، پادکست و ویدئو است.
کاربر میتواند محتوای موردنظر خود را وارد سیستم کند تا MY_Dict بهصورت خودکار **سطح دشواری متن را بر اساس CEFR (A1 تا C2)** تحلیل کرده، واژگان مهم و جدید را استخراج و کلمات غیرضروری و تکراری را فیلتر کند.
سپس با استفاده از هوش مصنوعی، **معنی واژهها را متناسب با context و جملهی اصلی** ارائه میدهد و آنها را وارد سیستم مرور هوشمند میکند. واژهها نیز بر اساس الگوریتم **Spaced Repetition (SM-2)** در زمان مناسب برای مرور مجدد نمایش داده میشوند.
هدف پروژه این است که فرآیند «پیدا کردن لغت → فهم معنی → ذخیره → مرور» را در یک محیط واحد و ساده انجام دهد.
صورت مسئله و نیاز سازمان (The Problem)
یادگیری لغات از طریق محتوای واقعی معمولاً با چند مشکل همراه است:
* مشخص نبودن سطح دشواری کتاب، مقاله یا فایل آموزشی
* اتلاف زمان برای جستجوی دستی کلمات ناشناخته
* نمایش معنی واژه بدون توجه کافی به context
* فراموش شدن لغات جدید به دلیل نبود سیستم مرور منظم
* دشواری استخراج و مدیریت واژگان از فایلهای مختلف
راهحل و قابلیتهای سامانه (The Solution)
MY_Dict این فرآیند را به یک جریان یکپارچه تبدیل میکند:
* **تحلیل سطح متن:** تشخیص سطح تقریبی محتوا بر اساس استاندارد CEFR از A1 تا C2
* **استخراج خودکار محتوا:** پردازش PDF، EPUB، متن و فایلهای صوتی و ویدیویی
* **استخراج و فیلتر واژگان:** شناسایی واژههای مهم و حذف کلمات تکراری یا کماهمیت
* **ترجمهی context-aware:** ارائهی معنی متناسب با جمله و موضوع با کمک هوش مصنوعی
* **تلفظ و Speech Recognition:** استفاده از قابلیتهای صوتی برای کمک به یادگیری و تمرین
* **مرور هوشمند:** مدیریت واژگان شخصی با الگوریتم Spaced Repetition (SM-2)
* **مدیریت واژگان:** دستهبندی و نگهداری واژههای یادگرفتهشده
* **رابط کاربری وب:** طراحی ساده و responsive برای استفاده در موبایل و دسکتاپ
* **خروجی و پشتیبانگیری:** امکان دریافت واژگان در قالب CSV/Excel و استفاده مجدد از دادهها
جریان کار و نحوه عملکرد سیستم (System Flow)
طراحی سامانه بر پایه معماری تمیز (Clean Architecture) به گونهای انجام شده که کار با آن برای کاربر نهایت سادگی را داشته باشد:
- رابط کاربری مدرن وب: پنل وب سبک و سریع با تم دارک و واکنشگرا برای مرور روزانه لغات و مدیریت دیتابیس شخصی.
- موتور پردازش و استخراج محتوا: استخراج متن و لغات از فایلهای PDF، EPUB و صوت با Speech-to-Text.
- هسته تحلیل سطح CEFR و تکرار فاصلهدار: ارزیابی دشواری متن بر اساس استانداردهای بینالمللی و زمانبندی مرور واژگان.
- موتور ترجمه هوشمند: تلفیق مدلهای زبانی Azure AI (GPT-4o) و گوگل با قابلیت چرخش خودکار کلیدها و پایداری بالا.
01
📚
۱. بارگذاری کتاب یا صوت
دریافت مستقیم کتابهای الکترونیکی، فایلهای PDF، متن یا فایل صوتی بدون نیاز به تایپ دستی.
02
📊
۲. سنجش سطح دشواری (A1-C2)
تحلیل آنی میزان سختی متن بر اساس سطوح استاندارد اروپایی جهت اطلاع از مناسب بودن محتوا.
03
🔍
۳. استخراج لغات کلیدی
فیلتر خودکار کلمات تکراری و ابتدایی و گلچین لغات ارزشمند و جدید برای یادگیری هدفمند.
04
🤖
۴. ترجمه مفهومی با AI
ارائه دقیقترین معنی واژه در بستر همان جمله، همراه با مثالهای ملموس و تلفظ صوتی.
05
🧠
۵. ایستگاه مرور (ضد فراموشی)
پیشنهاد هوشمند زمان مرور کلمات قبل از فراموشی طبق منحنی حافظه جهت تثبیت دائمی.
چالشهای فنی و نحوه حل آنها (Challenges & Solutions)
ترجمه دقیق اصطلاحات و کلمات چندمعنایی در بستر متن
صورت چالش
در متون انگلیسی بسیاری از لغات چند معنی کاملاً متفاوت دارند و دیکشنریهای معمولی معنایی ارائه میدهند که با موضوع متن همخوانی ندارد.
راهکار پیادهشده
اتصال سیستم به مدلهای زبانی هوش مصنوعی (GPT-4o) با تحلیل کل جمله و پاراگراف، تا دقیقترین و روانترین مفهوم متناسب با بستر متن ارائه شود.
دستاورد: درک کامل و بیابهام مفهوم واژهها و اصطلاحات خاص توسط کاربر.
جلوگیری از انباشتگی و فراموشی لغات جدید
صورت چالش
کاربران پس از استخراج دهها لغت از یک کتاب، بعد از چند روز اکثر آنها را فراموش میکنند چون نظم مشخصی برای مرور ندارند.
راهکار پیادهشده
پیادهسازی سیستم مرور با تکرار فاصلهدار (Spaced Repetition) که لغات دشوار را در فواصل نزدیکتر و لغات یادگرفتهشده را در فواصل طولانیتر به کاربر یادآوری میکند.
دستاورد: یادگیری عمیق و ماندگار در حافظه بلندمدت با صرف روزانه کمتر از ۵ دقیقه وقت مرور.
پشتیبانی از انواع فرمتهای مختلف بدون پیچیدگی برای کاربر
صورت چالش
کاربران تمایل دارند محتوا را از فایلهای مختلف مثل PDF کتاب، کتاب صوتی، یا فایل متنی استخراج کنند بدون اینکه درگیر خطاهای انکودینگ یا تبدیل فرمت شوند.
راهکار پیادهشده
یکپارچهسازی ماژولهای پردازش خودکار (pdfplumber, ffmpeg, speech-to-text) به صورتی که کاربر تنها فایل را آپلود میکند و نتیجه را مرتب و آماده تحویل میگیرد.
دستاورد: تجربه کاربری بسیار روان و صرفهجویی چشمگیر در وقت بدون نیاز به ابزارهای جانبی.
دستاوردها و نتایج کلیدی (Results & Impact)
* کاهش زمان موردنیاز برای استخراج و بررسی واژگان جدید از محتوای آموزشی
* امکان ارزیابی سریع سطح دشواری محتوای انگلیسی
* تبدیل واژگان پراکنده به یک مجموعهی شخصی و قابل مدیریت
* ایجاد چرخهی یادگیری و مرور منظم برای افزایش ماندگاری واژگان
* یکپارچهسازی پردازش متن، صوت، هوش مصنوعی و سیستم مرور در یک پلتفرم واحد